Intégrer un LLM dans une app Next.js : streaming, tool calling, coûts et sécurité
Un chatbot ou un assistant intégré à un produit, c'est aujourd'hui une demande fréquente. La démo est facile : un appel d'API et un champ texte. La version production pose d'autres questions : où vit la clé API, comment afficher la réponse au fil de l'eau, comment donner accès aux données du produit, combien ça coûte, et que se passe-t-il quand un utilisateur essaie de détourner le modèle.
L'architecture : tout passe par le serveur
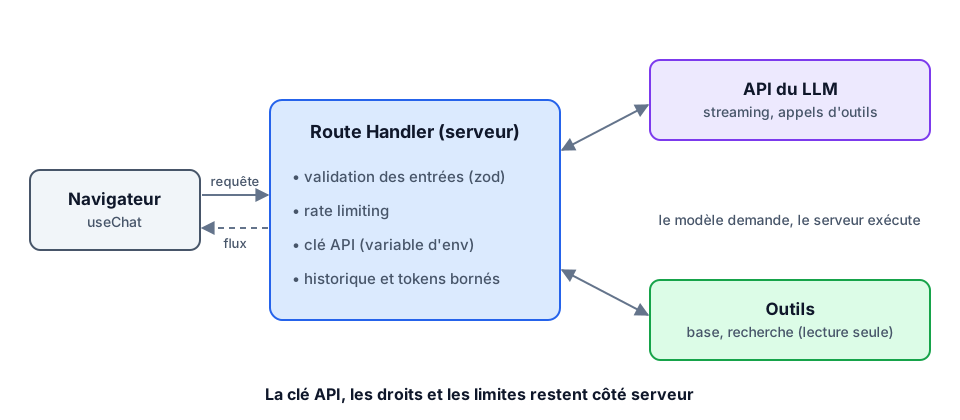
Le navigateur ne parle jamais directement au fournisseur du modèle. Un Route Handler Next.js sert d'intermédiaire : il garde la clé API, valide les entrées, applique les limites et exécute les outils.
Streaming et tool calling
Une réponse de LLM peut prendre plusieurs secondes. Le streaming affiche les premiers mots presque immédiatement, ce qui change complètement la perception. Le tool calling permet au modèle de demander l'exécution d'une fonction de votre code, puis d'utiliser le résultat dans sa réponse. Exemple avec le AI SDK :
// app/api/chat/route.ts
import { streamText, tool, convertToModelMessages, stepCountIs } from "ai";
import { z } from "zod";
import { model, SYSTEM_PROMPT } from "@/lib/ai";
import { searchProjects } from "@/lib/projects";
import { rateLimit } from "@/lib/rate-limit";

export async function POST(req: Request) {
  const ip = req.headers.get("x-forwarded-for") ?? "anonymous";
  if (!(await rateLimit(ip))) return new Response("Too many requests", { status: 429 });

  const { messages } = await req.json();

  const result = streamText({
    model,
    system: SYSTEM_PROMPT,
    messages: convertToModelMessages(messages.slice(-20)),
    maxOutputTokens: 800,
    stopWhen: stepCountIs(3),
    tools: {
      searchProjects: tool({
        description: "Recherche des projets du portfolio par technologie ou par domaine.",
        inputSchema: z.object({ query: z.string().max(100) }),
        execute: async ({ query }) => searchProjects(query),
      }),
    },
  });

  return result.toUIMessageStreamResponse();
}- `messages.slice(-20)` : on borne l'historique envoyé, sinon chaque échange coûte plus cher que le précédent.
- `stopWhen` : on limite le nombre d'allers-retours outil ↔ modèle pour éviter les boucles.
- `maxOutputTokens` : une réponse ne doit pas pouvoir exploser le budget.
Sorties structurées : ne jamais parser du texte libre
Dès que la réponse alimente du code (un formulaire prérempli, une classification, des tags), on demande une sortie structurée conforme à un schéma, et on la valide avec zod. Un JSON « presque correct » extrait par regex finira toujours par casser en production.
Maîtriser les coûts
- Choisir le bon modèle par tâche : un petit modèle rapide pour classer ou résumer, un grand modèle seulement quand le raisonnement le justifie.
- Prompt caching : le prompt système et les documents de référence sont identiques d'une requête à l'autre ; la plupart des fournisseurs permettent de les mettre en cache pour réduire fortement le coût et la latence.
- Limiter le débit par IP ou par utilisateur, et fixer un budget mensuel avec alertes chez le fournisseur.
- Mesurer : tokens en entrée et en sortie par requête, loggés avec l'identifiant de conversation.
Sécurité : l'injection de prompt
Tout ce que l'utilisateur écrit, et tout ce que les outils renvoient, peut contenir des instructions du type « ignore tes consignes précédentes ». Il n'existe pas de protection parfaite ; on limite donc ce que le modèle peut faire plutôt que ce qu'il peut lire :
- Des outils en lecture seule par défaut, avec des paramètres validés et un périmètre limité aux données publiques ou à celles de l'utilisateur connecté.
- Les droits viennent de la session, pas du prompt : l'identifiant utilisateur est injecté côté serveur, jamais demandé au modèle.
- Pas de secret dans le prompt système : considérez qu'il finira par être affiché.
- Échapper la sortie : la réponse du modèle est rendue comme du texte ou du Markdown filtré, jamais comme du HTML brut.
Évaluer avant de déployer
Changer de modèle ou modifier une ligne du prompt système peut dégrader des réponses qui fonctionnaient. Un petit jeu d'evals (une trentaine de questions réelles avec les critères attendus) lancé en CI, c'est l'équivalent des tests de non-régression pour un produit IA.
Conclusion
Intégrer un LLM, c'est surtout du travail full-stack classique : une API côté serveur, de la validation, du rate limiting, du cache, de l'observabilité et des tests. Le modèle n'est qu'une dépendance de plus, puissante, non déterministe et facturée au token, qu'il faut encadrer comme telle.