Rendre son site lisible par les IA : robots.txt, JSON-LD et llms.txt
Quand un recruteur demande à un assistant IA « Qui est Mohand Oussadi ? » ou « Quels développeurs Next.js ont de l'expérience en multi-tenant ? », la réponse dépend de ce que les robots d'IA ont pu lire sur le web. Le référencement ne concerne plus seulement Google : il faut aussi être lisible par les IA.
En auditant ce portfolio, j'ai découvert plusieurs problèmes qui rendaient une partie de mon contenu invisible. Voici la démarche, couche par couche.
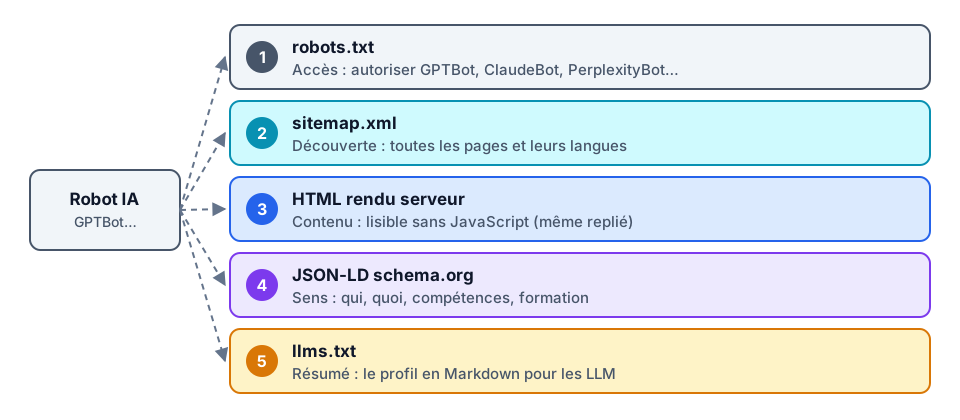
Couche 1 : autoriser l'accès (robots.txt)
Les robots d'IA respectent généralement robots.txt. Chaque fournisseur a ses propres agents : GPTBot et OAI-SearchBot (OpenAI), ClaudeBot et Claude-SearchBot (Anthropic), PerplexityBot, Google-Extended… Les autoriser explicitement lève toute ambiguïté.
Mon premier constat a été brutal : sur le site en ligne, /robots.txt renvoyait une erreur 500. La route dynamique [lang] interceptait l'URL et plantait, « robots.txt » n'étant pas une langue. Or, face à un robots.txt en erreur serveur, Google considère temporairement le site comme entièrement interdit à l'exploration.
// app/robots.ts
import type { MetadataRoute } from "next";

export default function robots(): MetadataRoute.Robots {
  return {
    rules: [
      { userAgent: "*", allow: "/" },
      { userAgent: ["GPTBot", "ClaudeBot", "PerplexityBot"], allow: "/" },
    ],
    sitemap: "https://mohand.oussadi.com/sitemap.xml",
  };
}
La correction complète : ce fichier, plus export const dynamicParams = false dans le layout [lang] pour que toute langue inconnue renvoie une 404 propre au lieu d'une erreur.
Couche 2 : lister les pages (sitemap.xml)
Un sitemap généré à partir des mêmes données que le site (pages, articles, versions française et anglaise avec leurs alternatives) garantit qu'aucune page n'est oubliée et qu'il reste à jour sans effort.
Couche 3 : du contenu dans le HTML
C'est le point le plus sous-estimé. La plupart des robots d'IA n'exécutent pas JavaScript : ils lisent le HTML renvoyé par le serveur, point. Tout ce qui n'y figure pas n'existe pas pour eux.
Le rendu serveur de Next.js règle l'essentiel… sauf pour le contenu masqué. Mes onglets et accordéons (Radix UI) ne rendaient pas le contenu fermé : le détail de mes expériences et toute ma formation étaient absents du HTML. La solution : forceMount, qui garde le contenu dans le HTML tout en le masquant à l'écran.
<AccordionContent forceMount className="data-[state=closed]:hidden">
  {job.responsibilities.map((r) => <li key={r}>{r}</li>)}
</AccordionContent>
Pour vérifier, un simple curl https://votre-site.com | grep "texte attendu" suffit : si le texte n'apparaît pas, les robots ne le voient pas.
Couche 4 : des données structurées (JSON-LD)
Le HTML dit quoi afficher ; les données structurées disent ce que c'est. Un bloc JSON-LD au vocabulaire schema.org décrit sans ambiguïté une personne, son métier, ses compétences, sa formation.
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Mohand Oussadi",
  "jobTitle": "Full-Stack Developer",
  "sameAs": ["https://www.linkedin.com/in/mohand-oussadi-091777106/"],
  "knowsAbout": ["React", "Next.js", "Node.js", "TypeScript"],
  "alumniOf": { "@type": "EducationalOrganization", "name": "Université Paris 12" }
}
Générez-le à partir de vos données existantes plutôt qu'à la main : il ne se désynchronisera jamais du contenu visible.
Couche 5 : un résumé pour les IA (llms.txt)
Proposé en 2024 par Jeremy Howard, llms.txt est un fichier Markdown à la racine du site qui résume son contenu pour les modèles de langage : qui, quoi, liens clés. Ce n'est pas encore un standard universellement exploité, mais il ne coûte presque rien. Sur ce site, il est généré au build à partir des compétences, expériences, projets et articles.
Et le reste de l'hygiène SEO
- Des titres et descriptions uniques par page.
- Des balises canoniques et `hreflang` pour un site multilingue.
- Pas de bourrage de mots-clés : la balise
keywordsest ignorée par les moteurs, et une liste de 70 termes ressemble à du spam.
Conclusion
Être lisible par les IA repose sur les mêmes fondations que le bon SEO, avec une exigence en plus : tout doit être dans le HTML. Vérifiez que robots.txt répond, que votre contenu apparaît dans un simple curl, décrivez-vous avec du JSON-LD, et ajoutez un llms.txt. Quelques heures de travail pour que les assistants parlent correctement de vous.